토큰 효율성이 여는 LPU 기반 AI 인프라의 미래
Session Overview
글로벌 인공지능(AI) 산업은 트랜스포머 기반 대규모 언어 모델(LLM)의 등장으로 급격한 변화를 맞이했으며, AI 컴퓨팅 인프라의 패러다임 또한 빠르게 재편되고 있다. 이번 강연에서는 LLM 추론(Inference) 서비스가 제기하는 새로운 컴퓨팅 과제와 이에 대응하기 위해 발전해 온 최신 AI 반도체 기술의 동향을 소개한다.
차세대 AI 추론 반도체인 LPU(LLM Processing Unit)는 LLM 추론 워크로드에 특화된 아키텍처를 기반으로, 서비스가 요구하는 지연시간과 처리량을 충족하는 동시에 주어진 비용과 전력으로 더 많은 토큰을 생성하는 '토큰 효율성(Token Efficiency)'을 핵심 목표로 설계됐다.
이는 AI 서비스의 총소유비용(TCO)을 획기적으로 낮추고, 폭발적으로 증가하는 AI 추론 수요를 지속가능하게 뒷받침하는 새로운 컴퓨팅 패러다임을 제시한다. LPU의 혁신적인 아키텍처와 설계 철학을 통해 AI 시대의 핵심 경쟁력이 단순한 연산 성능이 아니라 '토큰을 얼마나 경제적이고 지속가능하게 생성할 수 있는가'에 있음을 살펴보고, 차세대 AI 컴퓨팅 인프라의 방향과 미래를 함께 전망한다.
Speaker
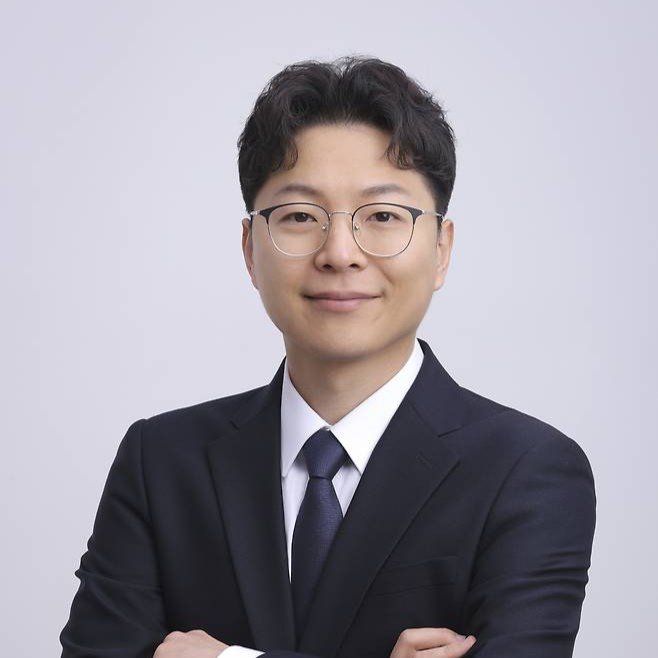
김주영 대표는 2023년 HyperAccel을 창업했으며, 대규모 언어 모델(LLM) 추론에 최적화된 AI 반도체 HyperAccel LPU(LLM Processing Unit)를 개발하며 차세대 AI 컴퓨팅 인프라를 선도하고 있다. 삼성 4나노 공정과 LPDDR5X 메모리를 기반으로 한 고효율 추론 가속기를 통해 전력과 비용 효율을 획기적으로 높인 AI 인프라 구현에 집중하고 있다.
AI 반도체 설계, 시스템 아키텍처, 컴퓨팅 플랫폼, 제품 상용화에 이르기까지 20년 이상의 연구 및 산업 경험을 보유하고 있으며, 이를 바탕으로 차세대 AI 컴퓨팅 기술의 연구개발과 사업화를 이끌고 있다.
이전에는 미국 마이크로소프트 본사에서 9년간 AI 가속기 및 컴퓨팅 인프라의 연구개발을 이끌었으며, 2019년부터 KAIST 전기및전자공학부 교수로도 재직 중이다.